
Förtroendeklyftan i AI-genererad kod: 64 % mot 88 %
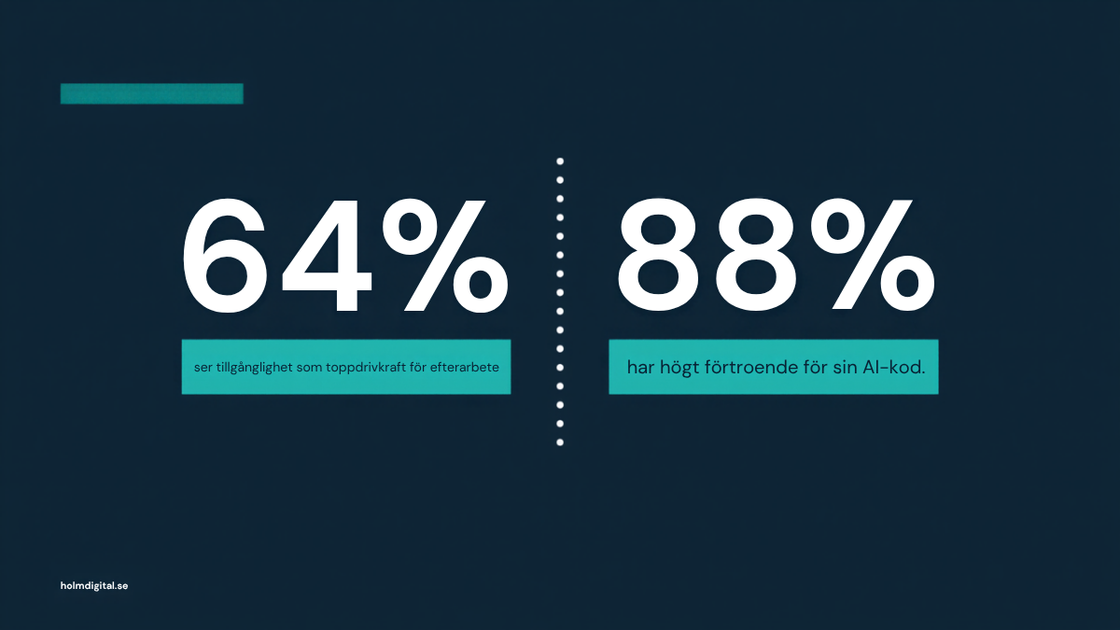
Ett gap på 24 procentenheter mellan hur säkra utvecklare är på sin AI-genererade kod och hur ofta den faktiskt behöver rättas i efterhand. Det är kärnan i en undersökning Deque Systems publicerade i somras, och den är värd att stanna vid.
Siffrorna
Deque tillfrågade 200 ingenjörsledare i USA. Alla på företag med mer än 30 miljoner dollar i omsättning som aktivt använder AI för att generera kod. 64 procent svarade att tillgänglighet är en av de största orsakerna till efterarbete i den AI-genererade koden. Samtidigt uppgav 88 procent att de har högt eller mycket högt förtroende för att just deras egen AI-genererade kod är tillgänglig.
Det är samma grupp människor som svarar på båda frågorna. Nästan alla litar på sin egen kod, medan ett stort flertal samtidigt pekar ut tillgänglighet som det som oftast måste rättas efteråt.
Viktigt att veta om källan: det här är Deques egen undersökning, inte oberoende branschdata. Deque säljer tillgänglighetsverktyg, och undersökningen är en del av deras marknadsföring. Siffrorna är ändå tydliga nog för att vara värda att diskutera, men läs dem som "Deque uppger", inte som en neutral sanning.
Den oberoende siffran
En sak i samma sammanhang är faktiskt oberoende verifierad. IBM Institute for Business Value publicerade i november förra året en rapport där 1 300 AI-beslutsfattare tillfrågades. Slutsatsen: företag som räknar in teknisk skuld i sina AI-kalkyler får 18 till 29 procentenheter högre avkastning än de som inte gör det.
IBM:s rapport handlar om AI-projekt i allmänhet, inte specifikt om tillgänglighet. Men den sätter en sifferbelagd prislapp på att ignorera skuld i en AI-satsning, tillgänglighetsskuld inräknad.
Ett gap mellan självtillit och verklig kvalitet är inte unikt för AI-kod. Det är samma mönster som syns i mänsklig kodgranskning också. Skillnaden är att det blir mer uttalat när tempot ökar, och volymen av genererad kod växer snabbare än teamets förmåga att granska den för hand.
Varför gapet finns
Vår egen tolkning: AI är bra på att gissa rätt mönster. Den har sett miljontals kodexempel och känner igen vad som "brukar" vara rätt. Den är sämre på att verifiera att mönstret faktiskt fungerar för en verklig användare med skärmläsare, tangentbordsnavigering eller röststyrning. Det kräver information AI:n inte har tillgång till under generering.
Förtroendet byggs alltså på att koden ser rätt ut, inte på att den är testad mot verklig användning. Det är en rimlig förklaring till varför så många har högt förtroende för kod som ändå, enligt samma personer, ofta behöver rättas.
Så bygger vi runt det
Det här är precis anledningen till att vår egen motor är byggd för att hellre flagga en osäker bedömning för mänsklig granskning än gissa. Ett fynd som inte går att verifiera automatiskt blir "needs review", inte ett godkännande. Vi har skrivit mer om hur och varför motorn resonerar så.
Poängen gäller lika mycket för AI-genererad kod som för AI-driven granskning: förtroende utan verifiering är bara en gissning som känns säker.
Vill ni veta hur er egen kodbas står sig, oavsett hur den skrevs? Boka en tillgänglighetsanalys.
Karin Holm Grundare, Holm Digital AB